Komunitas AI yang Saling Berbagi Bertumbuh
Hugging Face telah berkembang pesat dengan lebih dari 1 juta pengguna aktif setiap bulan.
Menciptakan lingkungan di mana pengetahuan tentang AI dapat ditukar secara bebas
📂Berbagi Sumber Daya: mengunggah model dan upgrade bersama
📜Kolaborasi: bekerja sama dalam suatu proyek
✏️Pendidikan dan Dukungan seperti tutorial, artikel
Mengenal Hugging Face
Temanku, bertukar pandangan dan saling bertumbuh, pastinya membutuhkan ruang dan media khusus bukan? Demikian juga dengan komunitas AI, dengan adanya wadah yang kredibel dan dipercaya memungkinkan para anggotanya bisa saling berbagi, belajar, dan berkembang bersama.
Mari mengenal lebih dekat dengan Hugging Face !.... Ini bukan hanya nama yang lucu; ini adalah titik kumpul komunitas AI terbesar dan paling aktif di dunia 🤗 .
Mengapa diciptakan ?
Didirikan di New York oleh Clément Delangue, Julien Chaumond, dan Thomas Wolf.Awalnya berfokus sebagai aplikasi chatbot interaktif yang ditujukan untuk remaja. Menggunakan teknologi pemrosesan bahasa alami (NLP).
Karena mereka melihat potensi yang luar biasa dalam pembelajaran mesin (machine learning) dan ingin membangun platform di mana para peneliti, pengembang, dan pemerhati dapat berbagi ide.
Dengan visi sederhana namun kuat: yaitu membuat AI lebih mudah diakses dan dipahami oleh semua orang. Maka model-model chatbot ini dijadikan open-source. Dan pada tahun 2018 dirilislah pustaka transformers yang menjadi titik balik besar bagi komunitas AI.
Pustaka Transformers ini bekerja dengan menyediakan akses cepat dan mudah ke model-model berbasis Transformer (seperti BERT, GPT, T5, dan RoBERTa) yang sudah dilatih sebelumnya (pre-trained models).
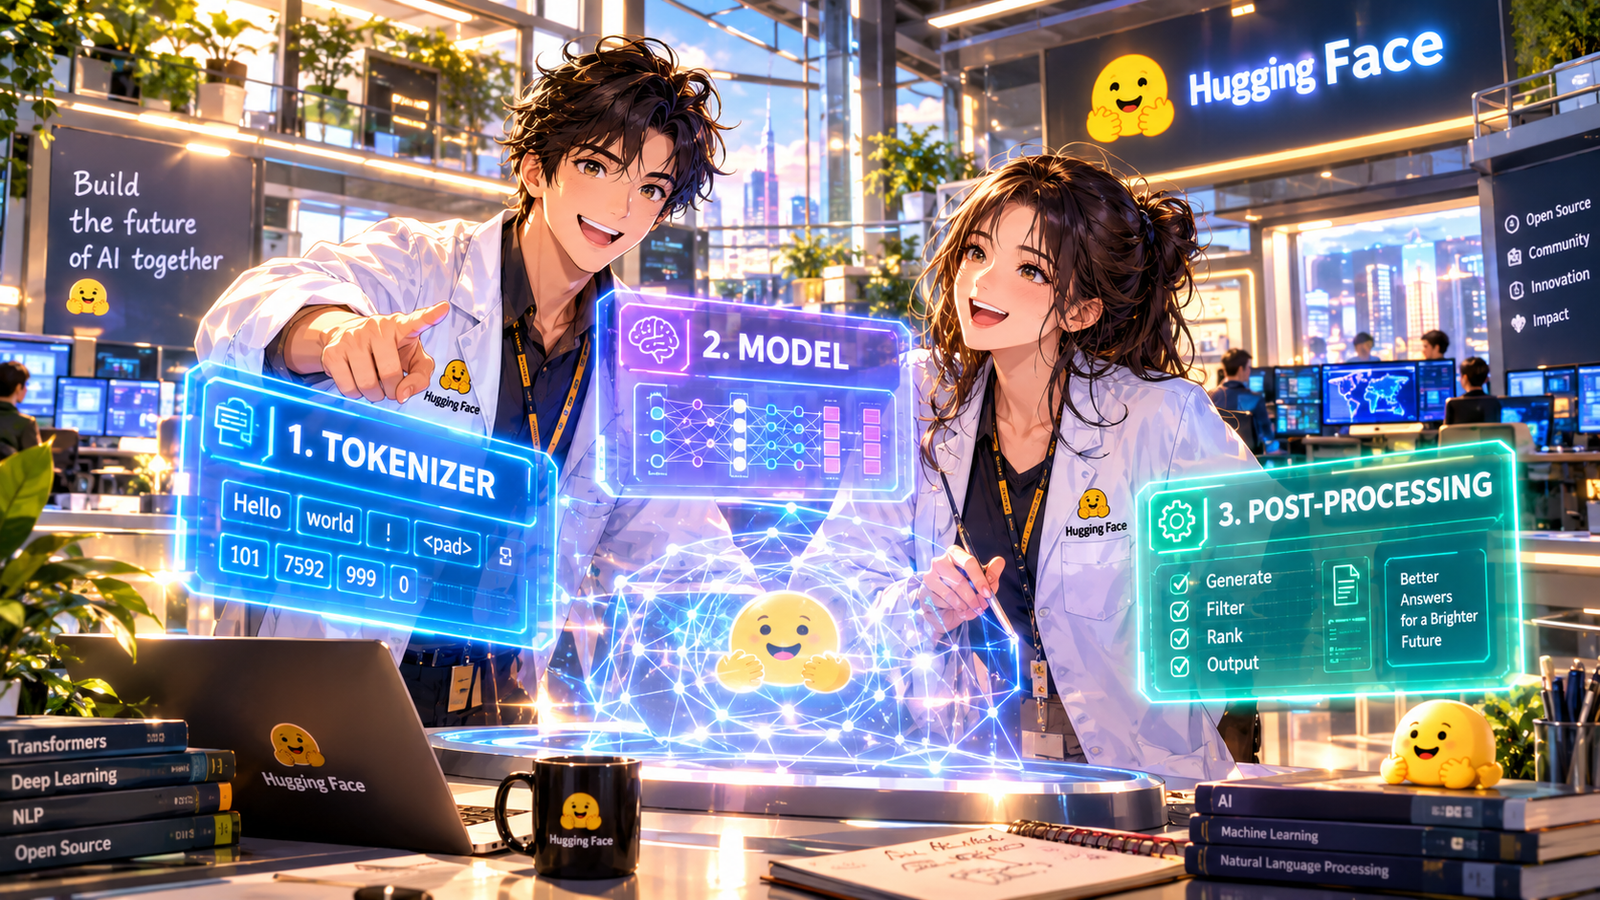
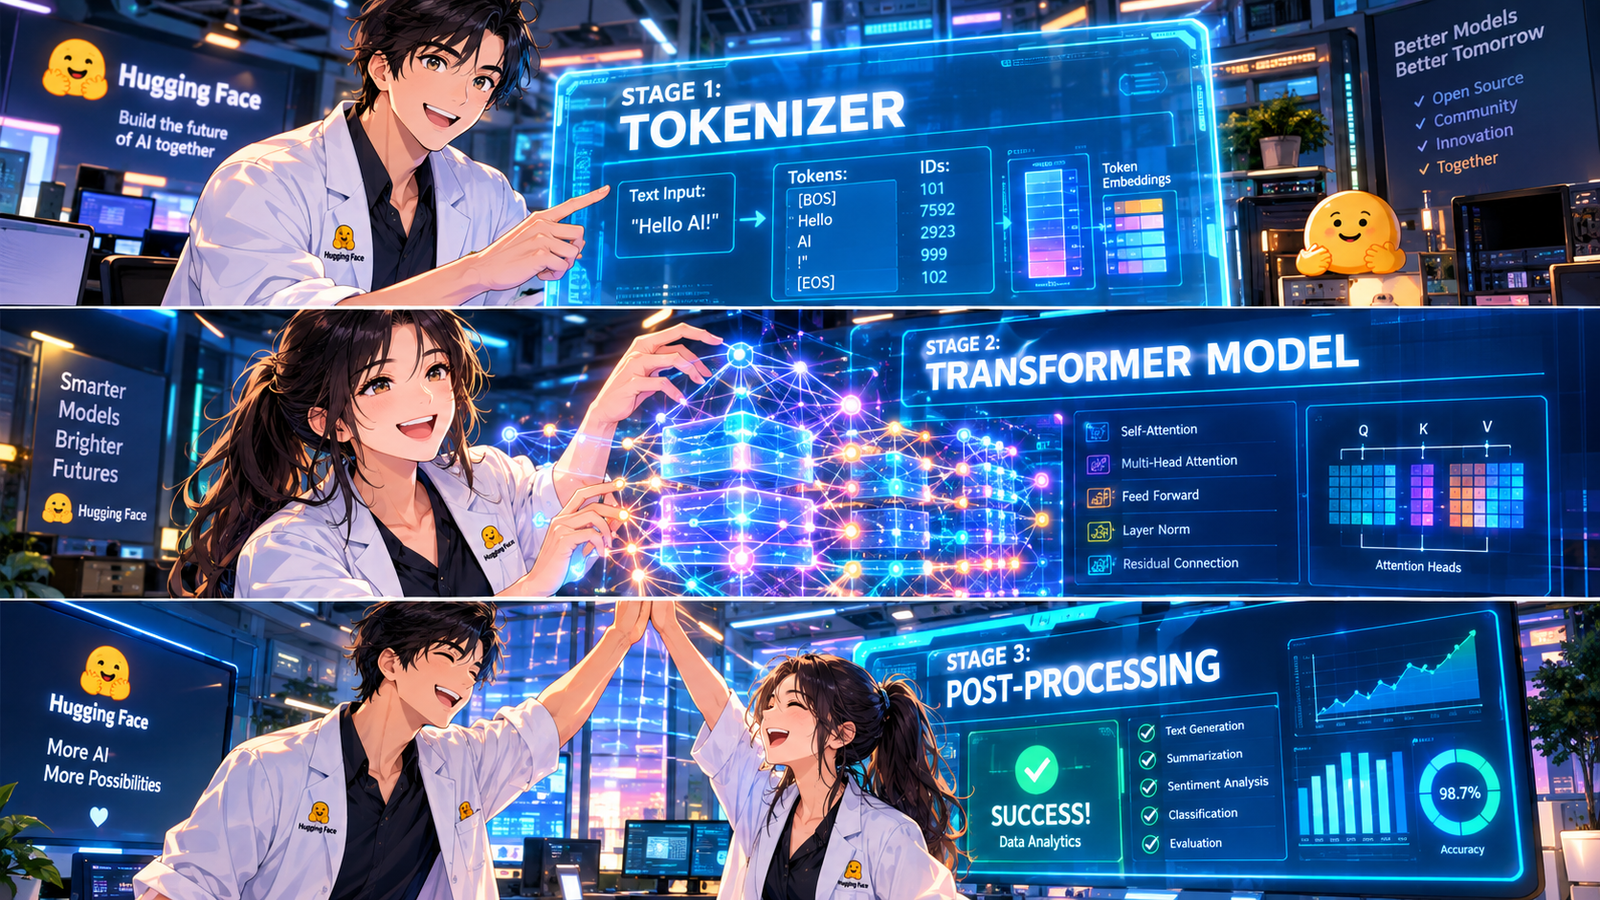
Secara garis besar, alur kerja pustaka ini dibagi menjadi tiga tahapan utama:
Teks Input ──> [ 1. Tokenizer ] ──> [ 2. Model ] ──> [ 3. Post-Processing ] ──> Hasil Prediksi
Buat kamu-kamu, biar gak mumet lihat kode Python yang panjang, mari kita bayangkan saja dulu cara kerja AI Hugging Face seperti proses di dapur restoran melalui 3 tahapan seru ini!"
1. Tokenizer
Mengubah Teks Menjadi Angka (Proses Potong & Siapkan Bahan-bahan)
Komputer itu dasarnya komputer, mereka gak paham bahasa manusia. Di tahap pertama ini, tugas Tokenizer adalah memotong-motong kalimat input kita menjadi potongan kata kecil (disebut token), lalu mengubah setiap kata itu menjadi kode angka unik. Ibaratnya, ini seperti koki yang lagi memotong daging dan sayur menjadi potongan kecil agar siap dimasak.
1️⃣Tokenisasi: Teks dipecah menjadi potongan-potongan kecil yang disebut token (bisa berupa kata atau sub-kata).
2️⃣Mapping: Setiap token diubah menjadi angka indeks unik berdasarkan kamus (vocabulary) bawaan model.
2️⃣Fungsi Utama: Mengembalikan tensors (representasi matriks angka) yang siap dimasukkan ke dalam arsitektur saraf model.
2. Model
Proses Inti & Mekanisme Perhatian (Proses Memasak & Racik Bumbu)
Nah, setelah jadi angka, barulah masuk ke otak AI-nya, yaitu Transformer Model. Di sini ada teknologi canggih bernama 'Self-Attention'. AI gak cuma baca kata satu per satu, tapi melihat hubungan antar semua kata sekaligus untuk paham konteksnya. Contohnya, AI bisa tahu bedanya kata 'bisa' yang artinya 'dapat' dengan 'bisa' ular. Ini seperti proses memasak di wajan, di mana semua bumbu saling meresap dan menyatu menghasilkan rasa yang pas."
1️⃣Self-Attention Mechanism: Model tidak hanya membaca kata satu per satu secara berurutan, melainkan melihat hubungan antar semua kata dalam satu kalimat secara bersamaan. Hal ini membuat model paham konteks (misalnya, kata "bisa" berarti dapat atau racun ular tergantung kalimatnya).
2️⃣Hidden States: Model menghasilkan representasi vektor matematis kaya makna dari teks input tersebut.
Singkatnya, setelah menerima angka dari Tokenizer, bagian Model akan memproses data tersebut menggunakan arsitektur neural network.
Bisa dikatakan bahwa inilah letak keunggulan teknologi Transformer.
3. Post-Processing / Head
Menghasilkan Output (Proses Plating / Penyajian)
Terakhir adalah Post-Processing. Output dari model tadi sebenarnya masih berupa angka-angka statistik yang rumit. Di tahap ini, angka tersebut dirapikan dan diubah kembali menjadi format yang dimengerti manusia. Kalau tugasnya tebak sentimen, AI akan mengeluarkan output tulisan: 'Sentimen Positif, Akurasi 99%'. Ibarat di restoran, ini adalah tahap menata makanan di piring cantik (plating) sebelum dihidangkan ke meja pelanggan.
1️⃣Klasifikasi Teks: Mengubah vektor menjadi prediksi label (misal: Sentiment Analysis -> Positif/Negatif).
2️⃣Generasi Teks: Memprediksi kata berikutnya yang paling logis untuk menyambung kalimat (seperti pada ChatGPT).
3️⃣Question Answering: Menentukan posisi kata di dalam teks teks yang menjadi jawaban dari pertanyaan.
Poin nya adalah, hasil mentah dari model kemudian disalurkan ke bagian "Kepala" (Head) spesifik, ini tergantung pada tugas AI yang ingin kamu selesaikan.
Demikian Hugging Face merangkum ketiga proses rumit di atas ke dalam satu fungsi instan bernama pipeline. Hanya dengan beberapa baris kode Python, pustaka ini otomatis mengunduh model, melakukan tokenisasi, dan menampilkan hasil.
Teman, hingga saat ini, Hugging Face telah berkembang pesat dengan lebih dari 1 juta pengguna aktif setiap bulan. Ini mencakup peneliti independen, mahasiswa, profesional industri, dan bahkan perusahaan besar seperti Google dan Microsoft yang menggunakan platform untuk menguji dan berbagi model AI mereka.
Hugging Face adalah bukti bahwa teknologi bisa menjadi jembatan antara individu dan ide-ide inovatif. Adanya komunitas aktif yang kuat, platform ini telah berhasil menciptakan ekosistem AI yang produktif dan saling mendukung.
Jadi, apakah kamu tertarik untuk bergabung? 🤗
Copyright 2026 All rights reserved